
1. 인메모리 저장소
🪦 관계형 데이터베이스 VS 메모리 데이터베이스
| 관계형 데이터베이스 | 메모리 데이터베이 |
| 하드디스크(HDD) 또는 SSD에 데이터를 저장 | RAM(메모리)에 데이터를 저장 |
| 디스크 I/O가 발생하여 상대적으로 느림 | 메모리 접근이므로 매우 빠름 |
| 영구적으로 저장해야 하는 데이터 | 자주 변경되거나 빠른 조회가 필요한 데이터 |
| 예) MySQL, PostgreSQL | 예) Redis |
📈 NoSQL Database
- Redis는 대표적인 NoSQL(Key-Value) 데이터베이스
- SQL을 사용하지 않음
- 스키마가 존재하지 않음(Schema-less)
- 데이터를 Key-Value 형태로 저장
user:1 -> value
🅰️ Redis 자료형(Data Type)
Redis는 Key는 항상 문자열(String) 이며, Value의 타입에 따라 사용할 명령어가 달라진다.
Key(String)
      │
      ▼
Value
 ├── String
 ├── List
 ├── Set
 ├── Hash
 └── Sorted Set
1️⃣ String
가장 기본적인 자료형이다.
Java로 보면
Map<String, String>과 비슷하게 사용할 수 있다.
주요 명령어
SET user:name alex
GET user:name

INCR user:count
DECR user:count

MSET name alex age 25
MGET name age
특징
- 최대 512MB 저장 가능
- 문자열뿐 아니라 이미지, 파일 등의 바이너리 데이터도 저장 가능
- 숫자라면 바로 증가/감소 가능
활용 사례
- 로그인 토큰
- 캐시 데이터
- 조회수
- 방문자 수
- API 응답 캐싱
2️⃣ List
문자열을 순서대로 저장하는 자료형이다.
내부적으로 QuickList 구조를 사용하여 앞뒤 삽입과 삭제가 매우 빠르다.
Java로 보면
Map<String, List<String>>처럼 생각하면 된다.
주요 명령어
LPUSH
RPUSH

LPOP
RPOP

LLEN

LRANGE
예시
LPUSH user:list alex
LPUSH user:list brad

RPUSH user:list chad
[brad, alex, chad]특징
- 앞뒤 삽입/삭제가 매우 빠름
- Queue 구현 가능
- Stack 구현 가능
활용 사례
- 작업 큐(Job Queue)
- 메시지 큐
- SNS 타임라인
3️⃣ Set
중복을 허용하지 않는 집합이다.
Java의
HashSet과 비슷하다.
주요 명령어
SADD
SREM

SMEMBERS

SISMEMBER

SCARD
집합 연산도 가능하다.
SINTER
SUNION
특징
- 중복 제거
- 순서 없음
- 존재 여부 확인이 O(1)
활용 사례
- 좋아요한 사용자 목록
- 중복 방문자
- JWT 블랙리스트
- 태그 관리
4️⃣ Hash
객체(Object)를 저장하기 위한 자료형이다.
Java로 보면
Map<String, Map<String, String>>형태이다.
예시
user:1

name -> alex
age -> 25
major -> CSE
주요 명령어
HSET

HGET

HMGET

HGETALL

HKEYS

HLEN
특징
하나의 Key 안에 여러 개의 Field-Value 쌍을 저장할 수 있어 객체(Object)를 표현하기에 적합하다.
user:1
 ├── name
 ├── age
 └── email
활용 사례
- 회원 정보
- 장바구니
- 상품 정보
- 프로필
5️⃣ Sorted Set
Set에 Score(점수) 가 추가된 자료형이다.
Score 기준으로 자동 정렬된다.
주요 명령어
ZADD

ZINCRBY

ZRANGE

ZRANK

ZREVRANGE

ZREVRANK
예시
alex 80
brad 95
chad 90
↓
자동 정렬
95 brad
90 chad
80 alex
특징
- 중복 없음
- Score 기준 자동 정렬
- 순위 조회가 빠름
활용 사례
- 게임 랭킹
- 리더보드
- 인기 게시글
- 인기 상품
- Rate Limiter
🔧 공통 명령어
자료형과 관계없이 사용할 수 있는 명령이다.
DEL
DEL user:1Key 삭제
EXPIRE
EXPIRE user:1 60TTL(Time To Live)을 설정한다.
60초 후 자동 삭제된다.
EXPIRETIME
EXPIRETIME user:1만료 시간을 Unix Timestamp로 확인한다.
KEYS
KEYS *현재 저장된 Key를 조회한다.
⚠️ 운영 환경에서는
KEYS명령은 모든 Key를 탐색하므로 성능에 영향을 줄 수 있어 사용을 지양하고, 대신SCAN명령을 사용하는 것이 권장된다.
FLUSHDB
FLUSHDB현재 DB의 모든 Key를 삭제한다.
2. 캐싱(Cache)
🍪 Session
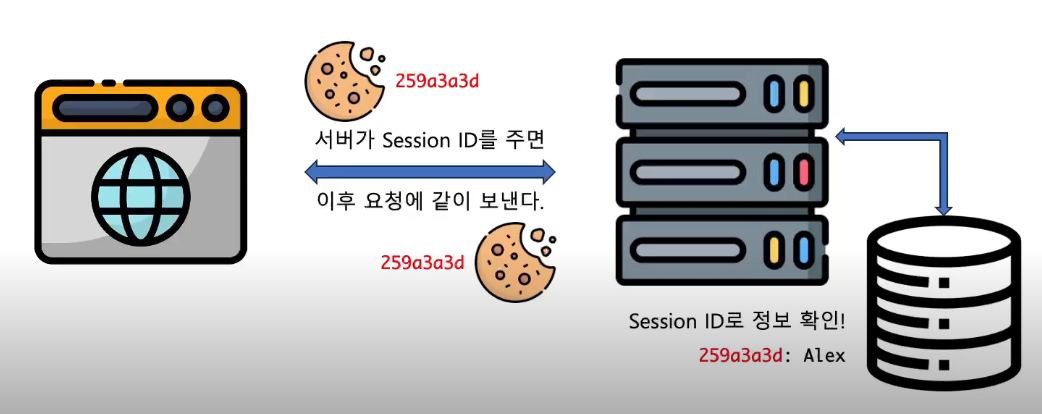
브라우저의 쿠키에는 Session ID가 저장된다.
- 실제 세션 데이터는 Tomcat과 같은 WAS 서버 내부 메모리에 저장된다.
❓ Scale-out 할 때 세션의 데이터는 어떻게 공유해야 할까?
1️⃣ Sticky Session
- Load Balancer가 이전 요청을 처리했던 동일한 서버로만 요청을 전달하는 방식
- 구현이 간단하지만 특정 서버에 부하가 집중될 수 있고, 서버 장애 시 세션이 유실될 수 있다.
2️⃣ Session Clustering
- 세션 정보를 서버 내부가 아닌 Redis와 같은 외부 저장소에 저장하는 방식
- 어떤 서버가 요청을 처리하더라도 동일한 세션 정보를 사용할 수 있다.
- 서버를 추가하거나 제거해도 세션을 유지할 수 있어 Scale-out 환경에 적합하다.
📋 LeaderBoard와 Sorted Set
❓ 언제 사용할까
- 게임의 실시간 랭킹 시스템
- 인기 게시글 조회
- 인기 상품 조회
- 실시간 검색어 순위
- 조회수, 좋아요 수 기반 순위 기능
- 점수 또는 가중치를 기준으로 정렬이 필요한 경우
🤔 관계형 데이터베이스로 구현하면?
예를 들어 이커머스에서 가장 많이 판매된 상품 TOP 10을 조회한다고 가정해 보자.
관계형 데이터베이스에서는 주문 테이블과 상품 테이블을 조인한 뒤 SUM() 또는 COUNT()와 같은 집계 함수를 사용해야 한다.
SELECT i.id, SUM(o.count)
FROM item i
INNER JOIN orders o
ON i.id = o.item_id
GROUP BY i.id
ORDER BY SUM(o.count) DESC
LIMIT 10;
이 방식은 데이터가 많아질수록 다음과 같은 문제가 발생한다.
- JOIN 연산 비용 증가
- GROUP BY와 ORDER BY에 따른 정렬 비용 발생
- 조회할 때마다 집계 연산 수행
- 실시간 랭킹을 자주 조회하는 서비스에서는 DB 부하 증가
이를 해결하기 위해 상품 테이블에 purchaseCount 컬럼을 두고 값을 증가시키는 방법도 있지만, 여전히 정렬을 위해 인덱스를 관리해야 하고 쓰기 작업도 매우 빈번하게 발생한다.
🚀 Sorted Set을 이용해보자
Redis의 Sorted Set(ZSET) 은 점수(score)를 기준으로 자동 정렬되는 자료구조이다.
member -> 상품 ID
score  -> 판매량
예를 들어
상품 A : 120
상품 B : 450
상품 C : 210
이라면 Redis 내부에서는
상품 B (450)
상품 C (210)
상품 A (120)
처럼 항상 정렬된 상태를 유지한다.
판매가 발생할 때마다
ZINCRBY ranking 1 item:1001처럼 점수만 증가시키면 되고,
상위 10개 상품은
ZREVRANGE ranking 0 9 WITHSCORES명령 하나로 바로 가져올 수 있다.
⚡ 시간 복잡도
| 명령어 | 시간 복잡도 |
| ZADD | O(log N) |
| ZINCRBY | O(log N) |
| ZRANGE / ZREVRANGE | O(log N + M) |
- N : 전체 데이터 개수
- M : 조회할 데이터 개수
즉, 상위 10개만 조회한다면 전체 데이터를 다시 정렬할 필요 없이 매우 빠르게 조회할 수 있다.
💡 왜 빠를까?
Sorted Set은 내부적으로
- Hash Table
- Skip List
를 함께 사용한다.
- Hash Table → Member를 빠르게 찾는다.
- Skip List → Score 순으로 정렬된 상태를 유지한다.
따라서 점수를 변경해도 전체 데이터를 다시 정렬하지 않고 필요한 위치만 이동시키므로 빠른 성능을 제공한다.
🗺️ 캐싱 개념과 캐싱 전략
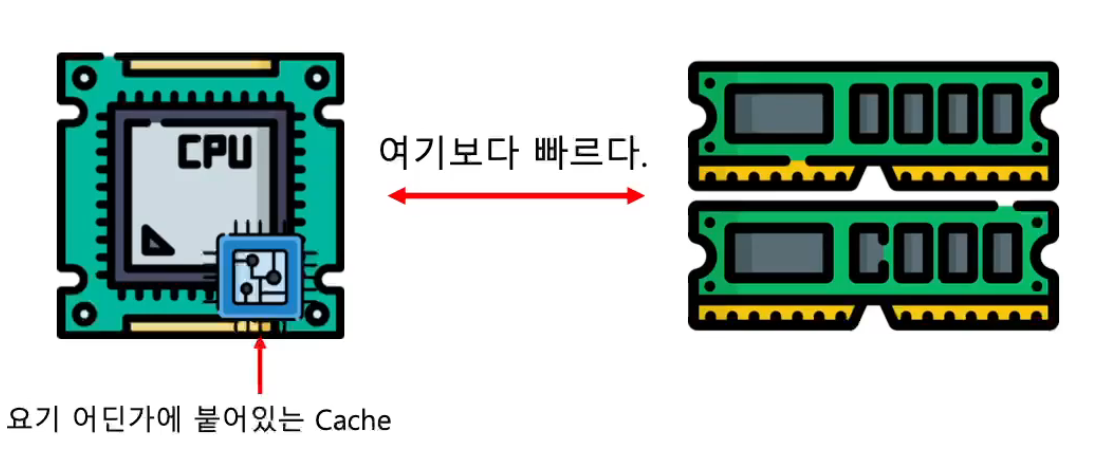
캐싱(Cache)이란 빈번하게 접근하는 데이터를 메모리(Redis)에 저장하여 데이터를 조회하는 데 걸리는 시간과 자원을 줄이는 기술이다.
📕 Caching 기본 용어
- Cache Hit : 캐시에 원하는 데이터가 존재하는 경우
- Cache Miss : 캐시에 원하는 데이터가 없는 경우
- Eviction Policy : 캐시 공간이 부족할 때 어떤 데이터를 제거할지 결정하는 정책
- Caching Strategy : 언제 캐시에 저장하고 언제 DB를 조회할지를 결정하는 전략
📍 Caching 전략
1️⃣ Cache-Aside

- 필요한 데이터만 캐시에 저장하는 방식
- 조회 시 먼저 캐시를 확인하고, 없으면 DB에서 조회한 뒤 캐시에 저장한다.
- 최초 요청(Cache Miss)은 DB를 조회하므로 상대적으로 느리다.
- 캐시의 TTL이 남아 있다면 DB를 조회하지 않으므로 최신 데이터와 차이가 발생할 수 있다.
2️⃣ Write-Through

- 데이터를 먼저 캐시에 저장한 뒤 동시에 DB에도 저장하는 방식
- 캐시와 DB의 데이터가 항상 동일하게 유지된다.
- 모든 쓰기 작업이 캐시와 DB에 모두 발생하므로 쓰기 성능이 상대적으로 낮다.
3️⃣ Write-Behind (Write-Back)
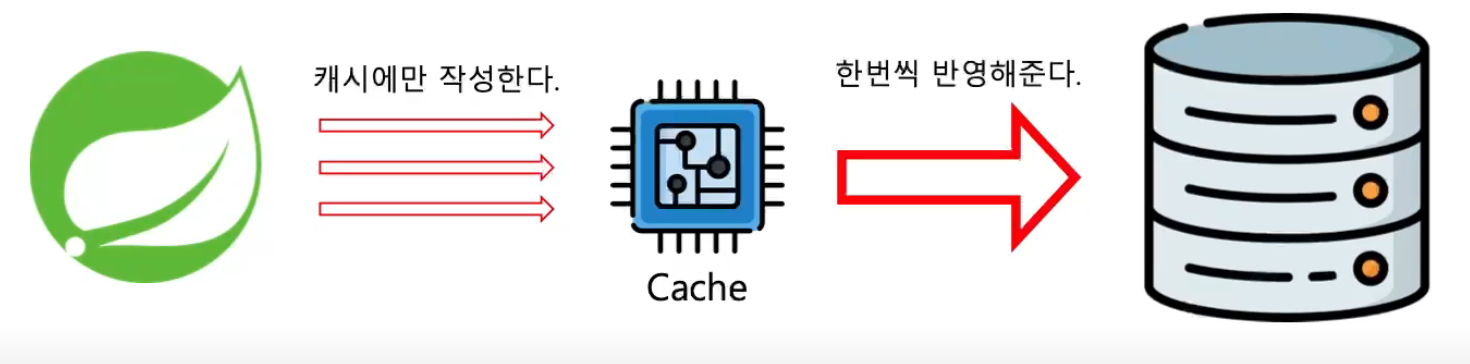
- 데이터를 우선 캐시에 저장하고 일정 주기마다 DB에 반영하는 방식
- 쓰기 성능이 매우 뛰어나며 DB 부하를 줄일 수 있다.
- DB에 반영되기 전에 장애가 발생하면 데이터가 유실될 위험이 있다.
📊 캐싱 전략 비교
| 전략 | 읽기 성능 | 쓰기 성능 | 데이터 최신성 | 대표 사용 사례 |
| Cache-Aside | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 보장되지 않음 | 대부분의 웹 서비스 |
| Write-Through | ⭐⭐⭐⭐ | ⭐⭐ | 항상 최신 | 금융, 주문 시스템 |
| Write-Behind | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 일정 시간 지연 | 로그, 통계 시스템 |
- Redis는 메모리 기반 NoSQL 데이터베이스로 매우 빠른 읽기/쓰기가 가능하다.
- String, List, Set, Hash, Sorted Set 등 다양한 자료구조를 제공하며 상황에 맞게 사용할 수 있다.
- Sorted Set은 Score 기반 자동 정렬을 지원하여 실시간 랭킹(LeaderBoard) 구현에 적합하다.
- Redis는 Session Clustering을 통해 여러 서버에서 동일한 세션을 공유할 수 있어 Scale-out 환경에 적합하다.
- 서비스 특성에 따라 Cache-Aside, Write-Through, Write-Behind 전략을 적절히 선택하면 성능과 데이터 일관성을 모두 고려한 캐시 시스템을 구축할 수 있다.
'개발 공부 > Java' 카테고리의 다른 글
| [TIL] 모니터링 시스템 및 시큐어 코딩 (0) | 2026.08.21 |
|---|---|
| [TIL] 대규모 시스템 설계 기초 (0) | 2026.07.28 |
| [TIL] Docker, Docker Compose, CI/CD, Amazon ECS (0) | 2026.07.27 |
| [TIL]MSA-보안부터 이벤트 드리븐까지 (0) | 2026.06.30 |
| [TIL] MSA - Eureka, LoadBalancer, FeignClient 이해하기 (0) | 2026.06.29 |