1. 트랜잭션
1. 트랜잭션이란?
데이터베이스에서 하나의 논리적인 작업 단위로 수행되어야 하는 연산들의 묶음
예를 들어 은콩이가 모리에게 10,000원을 계좌이체한다고 하면 두 작업이 필요하다.
1. 은콩이 계좌에서 10,000원을 차감
2. 모리 계좌에 10,000원을 추가
두 작업은 하나의 작업처럼 처리되어야 한다. 은콩이의 돈만 빠지고 모리에게 입금되지 않으면 안되기 때문에 두 연산을 하나의 트랜잭션으로 묶어 처리한다.
2. 트랜잭션의 특징
| 특징 | 개념 | 예시 |
| 원자성(Atomicity) | 트랜잭션이 데이터베이스에 모두 반영되던가 전혀 반영되지 않아야 한다는 것 | 은콩이 계좌에서 10,000원이 출금된 후 모리 계좌 입금에 실패하면, 은콩 계좌의 출금도 취소(Rollback)되어야 한다. |
| 일관성(Consistency) | 트랜잭션의 작업 처리 결과가 항상 일관성이 있어야 한다는 것 | 계좌이체 전후 은콩이와 모리의 전체 금액이 동일해야 하며, 잔액이나 데이터가 정의된 제약조건을 위반해서는 안 된다. |
| 격리성(Isolation) | 어떤 하나의 트랜잭션이라도 다른 트랜잭션의 연산에 끼어들 수 없다는 점 | 은콩이가 모리에게 송금하는 도중 다른 트랜잭션이 은콩이 계좌를 조회하더라도 처리 중인 불완전한 상태가 노출되지 않도록 한다. |
| 영구성(Durability) | 트랜잭션이 성공적으로 완료됐을 경우 결과는 영구적으로 반영되어야한다. | 계좌이체가 완료된 후 서버가 재시작되거나 장애가 발생해도 변경된 계좌 잔액은 유지되어야 한다. |
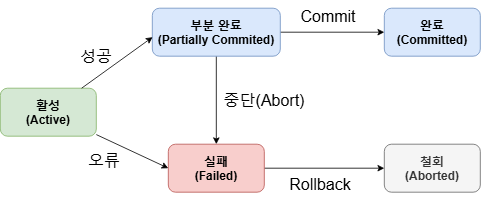
3. 트랜잭션의 상태
2. 리스트 자료구조
리스트(List)는 데이터를 순서대로 저장하는 선형 자료구조이다.
리스트를 구현하는 대표적인 방식으로 배열(Array)과 연결 리스트(Linked List)가 있다.
1. Array 특징
배열은 데이터를 연속된 메모리 공간에 저장하는 자료구조이다.
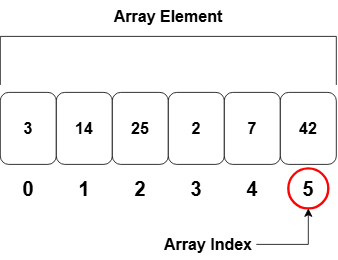
특징
- 데이터를 연속된 메모리 공간에 저장
- 인덱스를 통해 원하는 데이터에 바로 접근할 수 있다.
- 특정 위치의 데이터를 조회하는 속도가 빠르다
- 일반적인 배열은 생성할 때 크기가 결정되며 크기를 동적으로 변경하기 어렵다
- 중간에 데이터를 삽입하거나 삭제하면 이후 요소들을 이동시켜야 한다
예를 들어 B와 C 사이에 X를 삽입한다면
삽입 전
[A][B][C][D]

        ↓ C, D를 한 칸씩 이동

[A][B][X][C][D]
C, D를 뒤로 이동시켜 공간을 만들어야 하기 때문에 중간 삽입의 시간 복잡도는 O(n)이다.
Java의 ArrayList는 내부적으로 배열을 사용하는 동적 배열(Dynamic Array)이다. 저장 공간이 부족해지면 더 큰 배열을 생성하고 기존 요소를 새로운 배열로 복사한다.
2. LinkedList 특징
연결 리스트는 데이터를 연속된 공간에 저장하지 않고, 각각의 노드(Node)를 참조로 연결하여 데이터를 관리하는 자료구조이다.
각 노드는 데이터와 다음 노드를 가리키는 참조를 가지고 있다.
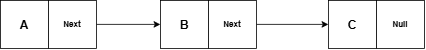
특징
- 각 데이터가 메모리의 서로 다른 위치에 저장될 수 있다.
- 각 노드는 다음 노드의 위치를 참조한다.
- 배열과 달리 인덱스를 이용해 특정 요소에 바로 접근할 수 없다.
- 원하는 데이터를 조회하려면 첫 번째 노드부터 순차적으로 탐색해야 한다.
- 삽입·삭제할 노드의 위치를 알고 있다면 주변 노드의 연결만 변경하면 되므로 요소를 이동할 필요가 없다.
예를 들어 A와 B 사이에 X를 삽입하면,
삽입 전

[A] → [B] → [C]

삽입 후

[A] → [X] → [B] → [C]
배열처럼 B, C를 이동하지 않고 노드의 연결 관계만 변경하면 된다.
단, 삽입할 위치를 찾는 과정부터 필요하다면 탐색에 O(n)이 걸리기 때문에 전체 삽입 작업 역시 O(n)이 될 수 있다.
3. ArrayList vs. LinkedList 성증 비교
| 연산 | Array | Linked List |
| 인덱스를 통한 조회 | O(1) | O(n) |
| 값 탐색 | O(n) | O(n) |
| 맨 앞 삽입·삭제 | O(n) | O(1) |
| 중간 삽입·삭제 | O(n) | O(1)* |
| 맨 뒤 삽입 | O(1) 또는 O(n)** | 구현에 따라 O(1) 또는 O(n) |
| 메모리 | 데이터 중심으로 저장 | 데이터 외에 참조를 저장할 추가 공간 필요 |
* 삽입·삭제할 노드를 이미 알고 있는 경우 O(1)이다. 해당 위치를 먼저 탐색해야 한다면 O(n)이다.
** 고정 크기 배열 자체는 단순히 "맨 뒤 삽입"이라는 연산으로 설명하기 애매하다. Java ArrayList 같은 동적 배열을 기준으로 하면 맨 뒤 추가는 일반적으로 O(1), 배열 확장이 발생하는 순간에는 O(n), 평균적으로는 Amortized O(1)이다.
4. 언제 사용하면 좋을까?
Array
- 특정 위치의 데이터를 자주 조회할 때
- 데이터의 삽입·삭제가 많지 않을 때
- 인덱스를 통한 빠른 접근이 중요할 때
Linked List
- 데이터의 삽입·삭제가 빈번할 때
- 특정 위치에 대한 임의 접근(Random Access)이 많이 필요하지 않을 때
- 삽입·삭제할 위치의 노드를 이미 가지고 있는 경우
한 줄 정리
Array는 인덱스를 이용한 조회가 O(1)로 빠르지만 중간 삽입·삭제 시 요소를 이동해야 하고, Linked List는 조회는 O(n)이지만 노드의 위치를 알고 있다면 연결 관계만 변경하여 O(1)에 삽입·삭제할 수 있다.
'CS & Algorithm > CS' 카테고리의 다른 글
| [CS] 컨텍스트 스위칭과 DNS (0) | 2026.08.24 |
|---|---|
| [CS] Java의 예외와 스프링의 트랜잭션 (0) | 2026.08.23 |
| [CS] 교착상태와 HTTP Method (0) | 2026.08.23 |
| [CS] Java equals와 hashCode, Spring DI (0) | 2026.08.19 |
| [CS] 인덱스와 해시 테이블 (0) | 2026.08.19 |