[TIL] 대규모 시스템 설계 기초
오늘은 대규모 시스템에서 반드시 알아야 하는 핵심 개념들을 학습했다. 단순히 서버를 만드는 것이 아니라, 많은 사용자가 동시에 접속해도 안정적으로 동작하도록 설계하는 방법에 대해 정리했다.
🚀 대규모 시스템이란?
대규모 시스템에서는 단순히 사용자 수보다 동시에 얼마나 많은 요청이 발생하는지가 훨씬 중요하다.
🙍 동시 접속자와 초당 요청량(TPS)
1. 사용자 수
얼마나 많은 사용자가 서비스를 이용하는지 파악하는 것이 중요하다.
기존 서비스라면 모니터링을 통해 하루 방문자 수를 확인할 수 있지만, 하루 접속자 수만으로는 충분하지 않다.
실제로 중요한 것은 동시에 얼마나 많은 사용자가 요청을 보내는가이다.
2. TPS (Transaction Per Second)
TPS는 초당 처리되는 요청(트랜잭션)의 수를 의미한다.
즉,
시스템이 초당 얼마나 많은 요청을 처리할 수 있는지를 나타내는 지표이다.
대규모 시스템에서는 사용자가 가장 많이 몰리는 시간대(Peak Time) 를 기준으로 시스템을 설계해야 한다.
예상보다 많은 요청이 몰리면 서버가 다운될 수 있기 때문에 여러 가지 대응 방법을 사용한다.
- 애플리케이션 서버 증설
- 메시지 큐를 이용한 대기열 구성
- Auto Scaling을 통한 동적 자원 확장
🧑💻 요청 종류에 따른 최적화
읽기(Read)와 쓰기(Write)는 성격이 다르기 때문에 최적화 방법도 달라진다.
📖 읽기(Read) 요청 최적화
조회 요청이 많은 서비스에서는 다음과 같은 방법을 사용한다.
- 캐시(Redis 등) 활용
- 데이터베이스 인덱스
- 읽기 전용(Read Replica) DB
- 데이터베이스 샤딩(Sharding)
- 쿼리 최적화 (불필요한 JOIN 제거, 필요한 컬럼만 조회)
🔥 Redis 캐시 사용 시 주의점
캐시에 객체 전체를 무분별하게 저장하면 메모리 사용량이 급격히 증가할 수 있다.
Redis 메모리가 부족하면 성능 저하는 물론 Connection Timeout 등의 문제가 발생할 수 있으므로 필요한 데이터만 캐싱하는 것이 중요하다.
✍️ 쓰기(Write) 요청 최적화
쓰기 작업은 데이터 변경이 발생하므로 읽기보다 비용이 크다.
주로 다음과 같은 방법을 사용한다.
- 메시지 큐를 이용한 비동기 처리
- Batch 처리
- 분산 데이터베이스
다만 분산 환경에서는 데이터 일관성(Data Consistency) 을 유지하는 것이 가장 중요한 과제이다.
📈 데이터 일관성 유지
1. 분산 트랜잭션
여러 개의 데이터베이스나 서비스에 걸친 작업을 하나의 트랜잭션처럼 처리하는 방법이다.
대표적인 방법으로는 다음이 있다.
✔ 2PC (Two Phase Commit)
분산 트랜잭션을 관리하는 대표적인 프로토콜이다.
- Prepare 단계
- Commit 단계
모든 참여자가 성공해야 최종 Commit이 이루어진다.
✔ Saga Pattern
긴 트랜잭션을 여러 개의 작은 트랜잭션으로 나누어 처리한다.
각 단계는 독립적으로 Commit하며,
실패하면 보상 트랜잭션(Compensation Transaction) 을 실행하여 이전 작업을 취소한다.
MSA 환경에서 가장 많이 사용하는 방식이다.
✔ Event Sourcing
데이터 자체를 저장하는 것이 아니라
상태 변화(Event)를 저장하는 방식이다.
| 장점 | 단점 |
| 데이터 일관성 보장 | 복잡성 증가 |
| 확장성 | 성능 저하 |
| 신뢰성 | 네트워크 오버헤드 |
| 복구 가능성 | 복구의 어려움 |
📝 Event Sourcing
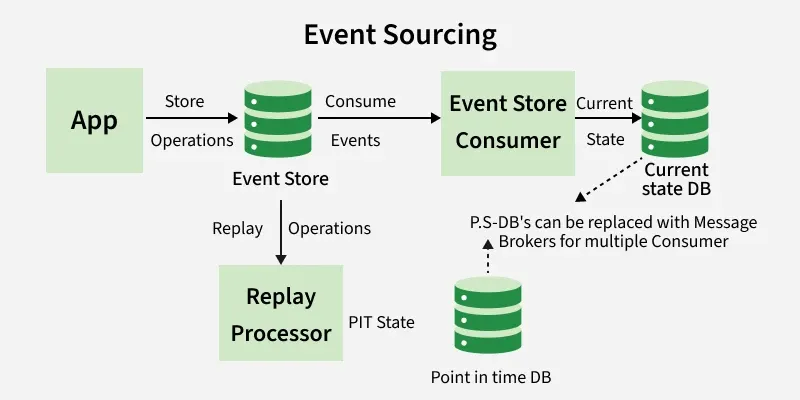
Event Sourcing은
현재 상태를 저장하는 것이 아니라 이벤트를 저장하는 방식이다.
즉,
회원 가입
↓

닉네임 변경
↓

비밀번호 변경
↓

탈퇴
처럼 모든 변경 내역을 저장하고,
필요할 때 이벤트를 순서대로 재생하여 현재 상태를 만든다.
주요 구성 요소
- Event
- Event Store
- Aggregate
- Command
- Projection
| 장점 | 단점 |
| 데이터 변경 이력 추적 | 복잡성 증가 |
| 복구 및 재생 | 읽기 성능 저하 |
| CQRS와의 자연스러운 통합 |
⚡ CQRS
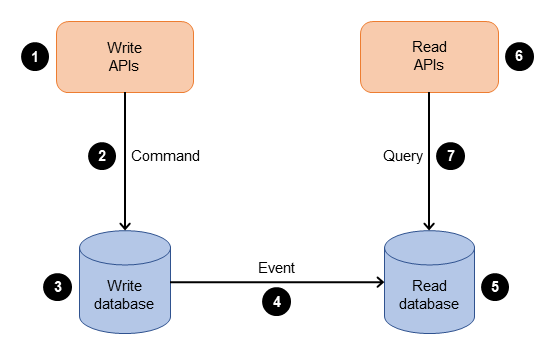
CQRS(Command Query Responsibility Segregation)는
명령(Command)과 조회(Query)의 책임을 분리하는 설계 방식이다.
즉,
읽기 모델과 쓰기 모델을 별도로 운영한다.
쓰기(Command)

↓

Database

↓

조회(Query)
읽기와 쓰기의 성격이 다르기 때문에
각각에 맞게 독립적으로 최적화할 수 있다.
| 장점 | 단점 |
| 성능 향상 | 복잡성 증가 |
| 확장성 | 데이터 동기화 |
| 유지보수성 | |
| 데이터 일관성 |
🖥️ 모니터링과 로깅
📈 모니터링
운영 환경에서는 시스템 상태를 실시간으로 확인해야 한다.
대표적인 도구
- Prometheus
- Grafana
모니터링을 통해
- 시스템 상태 확인
- 자동 알림
- 성능 분석
- 병목 지점 파악
- 장애 예방
등이 가능하다.
📜 로깅
로그는 문제 발생 시 원인을 추적하기 위한 가장 중요한 데이터이다.
대표적인 도구
- Elasticsearch
- Logstash
- Kibana (ELK)
로그를 통해
- 이벤트 추적
- 디버깅
- 패턴 분석
- 장애 원인 분석
등을 수행할 수 있다.
🧪 테스트와 배포
테스트
운영 환경에 배포하기 전 다양한 테스트가 필요하다.
- 단위 테스트
- 통합 테스트
- 부하 테스트
- 회귀 테스트
- 사용자 수용 테스트(UAT)
배포 전략
대표적인 배포 전략은 다음과 같다.
Canary 배포
일부 사용자에게 먼저 배포하여 문제가 없는지 확인
Blue-Green 배포
기존 환경과 새로운 환경을 동시에 운영한 뒤 트래픽을 전환
Rolling 배포
서버를 하나씩 순차적으로 교체하며 배포
📨 RabbitMQ
RabbitMQ는 메시지 브로커(Message Broker) 이다.
프로듀서와 컨슈머 사이에서 메시지를 전달하는 역할을 한다.
Producer

↓

Exchange

↓

Queue

↓

Consumer
주요 역할
- 비동기 처리
- 부하 분산
- 장애 발생 시 메시지 보존
Exchange 종류
Direct Exchange
라우팅 키가 정확히 일치하는 큐로 전달
Topic Exchange
패턴 기반 라우팅
Fanout Exchange
모든 큐로 브로드캐스트
Headers Exchange
헤더 정보를 기준으로 라우팅
| 장점 | 단점 |
| 신뢰성 | 설정 및 운영 복잡성 |
| 유연성 | 메시지 브로커 오버헤드 |
| 확장성 | 대규모 메시지 처리 시 성능 저하 발생 |
| 관리 및 모니터링 | 운영 비용 |
| 높은 처리량 | 제한된 메시지 크기 |
| 러닝 커브 |
💺 Kafka
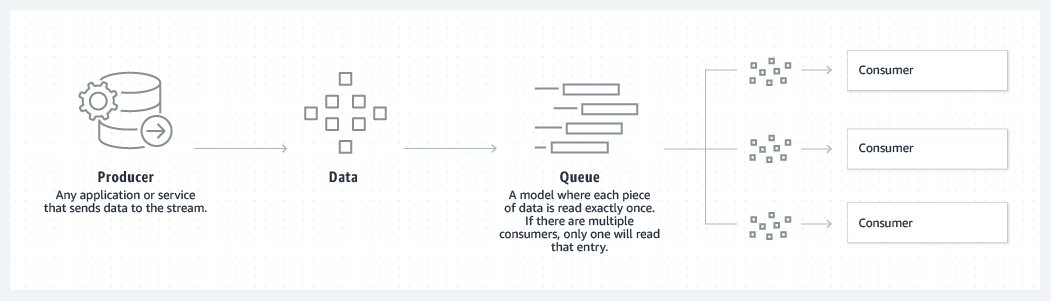
Kafka는 분산 스트리밍 플랫폼이다.
RabbitMQ와 비슷해 보이지만,
메시지를 장기간 저장하고 대용량 데이터를 실시간으로 처리하는 데 목적이 있다.
Producer

↓

Topic

↓

Partition

↓

Broker

↓

Consumer
주요 역할
- 실시간 데이터 처리
- 데이터 통합
- 내결함성
주요 구성 요소
- Producer
- Topic
- Partition
- Key
- Consumer
- Broker
- ZooKeeper(기존 Kafka에서 클러스터 관리 역할)
최근 Kafka는 ZooKeeper 없이 동작하는 KRaft 모드를 기본으로 사용하는 추세이다.
| 장점 | 단점 |
| 신뢰성 | 설정 및 운영 복잡성 |
| 유연성 | 브로커 오버헤드 |
| 확장성 | 대규모 메시지 처리 시 성능 저하 |
| 높은 처리량과 저지연 | 운영 비용 |
| 관리 및 모니터링 | 러닝커드 |
⚔️ RabbitMQ vs Kafka
| RabbitMQ | Kafka | |
| 설계 철학 | 전통적인 메시지 브로커 메시지의 안정적 전달과 큐잉에 중점 |
분산 스트리밍 플랫폼 대규모 실시간 데이터 스트림의 저장과 분석에 중점 |
| 메시지 모델 | 큐를 중심으로 메시지 전달 메시지는 큐에 저장되고 큐에서 하나 이상의 컨슈머에게 전달 |
토픽 중심으로 메시지 저장 메시지는 토픽의 파티션에 저장되고 컨슈머는 파티션에서 메시지를 읽음 |
| 메시지 지속성 | 메모리나 디스크에 저장 단기 저장을 목표로 함 |
디스크에 저장 장기 저장을 목표로 함 데이터 로그는 설정된 기간동안 보존 |
| 사용 | 갖업 큐, 요청/응답 패턴, 비동기 작업 처리 등 전통적인 메시지 큐 사용 사례에 적합 | 실시간 데이터 스트리밍, 로그 수집 및 분석, 이벤트 소싱 등 대규모 데이터 스트림 처리에 적합 |
📌 정리
- 대규모 시스템은 높은 TPS와 동시 접속자를 안정적으로 처리할 수 있도록 설계하는 것이 핵심이다.
- 읽기 성능은 캐시, 인덱스, Read Replica, 샤딩 등으로 최적화한다.
- 쓰기 성능은 비동기 처리, 배치 처리, 메시지 브로커 등을 활용해 개선한다.
- 분산 시스템에서는 Saga Pattern, Event Sourcing, CQRS 등을 통해 데이터 일관성을 관리한다.
- RabbitMQ는 작업 큐와 비동기 처리에 적합한 메시지 브로커이고, Kafka는 이벤트를 장기간 저장하며 대용량 실시간 데이터 스트리밍에 최적화된 플랫폼이다.
- 안정적인 운영을 위해서는 모니터링(Prometheus, Grafana) 과 로깅(ELK), 그리고 CI/CD 및 다양한 배포 전략이 함께 구축되어야 한다.