1. CPU 스케줄링
1. CPU 스케줄링이란?
CPU 스케줄링은 여러 프로세스가 CPU를 사용하려고 할 때 어떤 프로세스에게 CPU를 할당할지 운영체제가 결정하는 과정이다.
하나의 CPU 코어는 한 순간에 하나의 작업을 실행할 수 있다.
따라서 여러 프로세스가 동시에 실행 가능한 상태라면 운영체제는 CPU를 효율적으로 사용하기 위해 어떤 프로세스를 먼저 실행할지 결정해야한다.
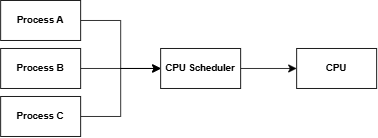
멀티코어 환경에서는 여러 프로세스가 실제로 동시에 실행될 수 있지만 각 CPU 코어에 어떤 작업을 할당할지는 여전히 스케줄링이 필요하다.
2. CPU 스케줄링이 필요한 이유
CPU를 사용하려는 프로세스는 여러 개일 수 있지만 CPU라는 자원은 한정되어 있다.
만약 하나의 프로세스가 CPU를 오랫동안 독점한다면 다른 프로세스는 실행되지 못하고 계속 기다려야 한다.
따라서 운영체제는 CPU 스케줄링을 통해 CPU를 적절하게 분배해야 한다.
CPU 스케줄링의 주요 목적은 다음과 같다.
- CPU 사용률 향상
- 처리량(Throughput) 향상
- 대기 시간(Waiting Time) 감소
- 응답 시간(Response Time) 감소
- 여러 프로세스에 CPU를 공정하게 할당
3. 선점형 스케줄링
현재 실행 중인 프로세스가 있더라도 운영체제가 CPU 사용권을 강제로 회수해 다른 프로세스에게 할당할 수 있는 방식이다.
예를 들어 Round Robin 방식에서는 각 프로세스에 일정한 CPU 사용 시간(Time Quantum)을 부여한다.
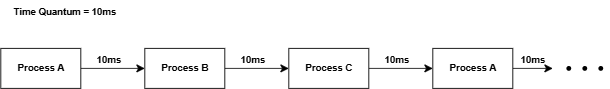
A의 작업이 끝나지 않았더라도 주어진 시간이 끝나면 운영체제가 CPU 사용권을 회수하고 다음 프로세스에게 넘긴다.
이러한 방식은 특정 프로세스가 CPU를 오랫동안 독점하는 것을 방지할 수 있으며, 사용자와 상호작용하는 시스템에서 빠른 응답을 제공하는 데 유리하다.
하지만 프로세스를 자주 전환하면 Context Switching이 많이 발생하기 때문에 그에 따른 오버헤드가 발생할 수 있다.
대표적인 선점형 스케줄링 알고리즘으로는 다음과 같은 것들이 있다.
- Round Robin
- SRTF(Shortest Remaining Time First)
- 선점형 Priority Scheduling4. 비선점형 스케줄링한 프로세스가 CPU를 할당 받으면 해당 프로세스가 CPU를 자발적으로 반환할 때까지 운영체제가 강제로 CPU를 회수하지 않는 방식이다.
프로세스가 종료되거나 I/O 작업 등으로 대기 상태가 되어 CPU를 반환하면 그때 다른 프로세스에게 CPU가 할당된다.
선점형보다 Context Switching이 적어 구현이 비교적 단순하고 전환에 따른 오버헤드가 적다는 장점이 있다.
반면 CPU를 오래 사용하는 프로세스가 존재하면 다른 프로세스의 대기 시간이 길어질 수 있다.
대표적인 비선점형 스케줄링 알고리즘은 다음과 같다.
- FCFS(First Come First Served)
- SJF(Shortest Job First)
- 비선점형 Priority Scheduling2. TCP와 UDP데이터를 전송하기 전에 송신자와 수신자 사이에 논리적인 연결을 설정하고 데이터를 전송하는 연결 지향형 프로토콜이다.
2. TCP와 UDP
1. TCP란?
TCP는 데이터를 전송하기 전에 3 Way Handshake를 통해 연결을 설정한다.
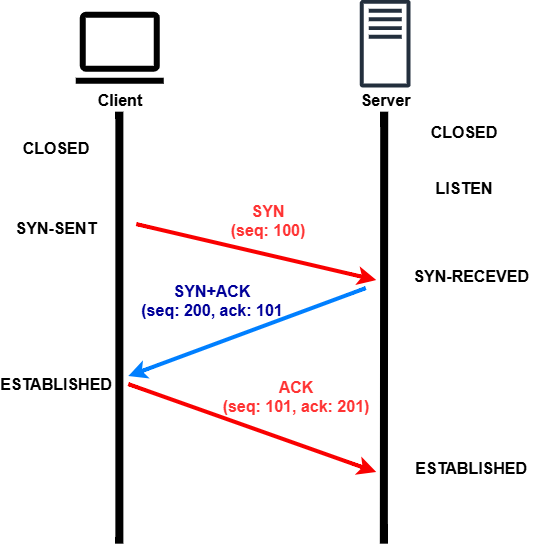
연결이 설정된 이후 데이터를 전송한다.
TCP는 데이터가 정상적으로 전달되었는지 확인하고 데이터가 유실되면 재전송하는 등의 방법을 통해 신뢰성 있는 데이터 전송을 보장한다.
또한 데이터의 순서를 보장하기 때문에 전송 순서가 중요한 서비스에 적합하다.
2. TCP의 특징
TCP의 주요 특징은 다음과 같다.
- 연결 지향
데이터를 전송하기 전에 송신자와 수신자 사이에 연결을 설정한다.
- 신뢰성 보장
데이터가 정상적으로 전달되었는지 확인하고 데이터가 유실된 경우 재전송할 수 있다.
- 순서 보장
여러 데이터가 전송되었을 때 수신 측에서 올바른 순서로 데이터를 처리할 수 있도록 한다.
- 흐름 제어
수신자가 처리할 수 있는 속도보다 송신자가 지나치게 빠르게 데이터를 보내지 않도록 조절한다.
- 혼잡 제어
네트워크가 혼잡한 상황에서 데이터 전송량을 조절한다.
이러한 기능을 제공하기 때문에 신뢰성이 높지만 UDP보다 상대적으로 추가적인 오버헤드가 발생한다.
3. UDP란
UDP(User Datagram Protocol)는 TCP와 달리 송신자와 수신자 사이에 연결을 설정하지 않고 데이터를 전송하는 비연결형 프로토콜이다.
TCP처럼 연결을 위한 3-Way Handshake를 수행하지 않는다.
또한 기본적으로 데이터가 정상적으로 도착했는지 확인하거나 손실된 데이터를 재전송하지 않는다.
따라서 TCP보다 신뢰성은 떨어지지만 프로토콜 자체의 오버헤드가 작아 빠르고 단순한 데이터 전송이 필요한 상황에 적합하다.
4. TCP와 UDP는 어디에 사용할까?
TCP
데이터의 정확성과 순서가 중요한 서비스에 적합하다.
예를 들어 파일을 다운로드하는 과정에서 데이터 일부가 사라지면 파일 자체가 손상될 수 있기 때문에 신뢰성 있는 데이터 전송이 중요하다.
대표적인 예시는 다음과 같다.
- HTTP/1.1, HTTP/2
- 파일 전송
- 이메일
- SSH
- 데이터의 정확성이 중요한 통신
UDP
일부 데이터가 유실되는 것보다 실시간성이 중요한 서비스에 적합하다.
예를 들어 실시간 음성 통화에서 아주 짧은 음성 데이터 하나가 손실되었다고 몇 초 뒤 다시 전송한다면 이미 대화 시점이 지나갔기 때문에 재전송의 가치가 낮을 수 있다.
따라서 다음과 같은 서비스에서 UDP를 활용할 수 있다.
- 실시간 음성/영상 통신
- 온라인 게임
- DNS
- 일부 스트리밍 및 실시간 전송
단, 실제 서비스가 UDP를 사용한다고 해서 애플리케이션 수준에서도 반드시 신뢰성을 포기하는 것은 아니다. 필요한 경우 UDP 위에서 애플리케이션 또는 상위 프로토콜이 손실 복구나 순서 제어 등의 기능을 별도로 구현할 수도 있다.
'CS & Algorithm > CS' 카테고리의 다른 글
| [CS] RabbitMQ vs Kafka (0) | 2026.09.15 |
|---|---|
| [CS] GC와 Spring MVC 요청 처리 과정 (0) | 2026.09.03 |
| [CS] DB JOIN과 이진 탐색 (0) | 2026.08.30 |
| [Plus] Let’s Encrypt 인증서를 적용하면 HTTPS는 어떻게 동작할까? (0) | 2026.08.30 |
| [CS] 가상 메모리와 HTTP vs. HTTPS (0) | 2026.08.30 |