1. INNER JOIN과 LEFT OUTER JOIN
1. JOIN이란?
관계형 데이터베이스에서 두 개 이상의 테이블을 특정 칼럼을 기준으로 연결하여 데이터를 조회하는 방법.
예를 들어 회원 정보를 저장하는 users 테이블과 주문 정보를 저장하는 orders 테이블이 있다고 가정하자.
users
| id | name |
| 1 | 은콩이 |
| 2 | 모리 |
| 3 | 티모 |
orders
| id | user_id | product |
| 101 | 1 | 키보드 |
| 102 | 1 | 마우스 |
| 103 | 2 | 모니터 |
orders.user_id는 주문을 생성한 사용자의 users.id를 참조한다고 가정한다.
2. INNER JOIN
두 테이블에서 JOIN 조건을 만족하는 데이터만 조회한다.
SELECT u.id, u.name, o.product
FROM users u
INNER JOIN orders o
    ON u.id = o.user_id;
결과는 다음과 같다.
| id | name | product |
| 1 | 은콩이 | 키보드 |
| 1 | 은콩이 | 마우스 |
| 2 | 모리 | 모니터 |
티모는 users 테이블에는 존재하지만 주문 데이터가 존재하지 않는다.
users.id = orders.user_id
를 만족하는 데이터가 없기 때문에 결과에 포함되지 않는다.
즉, INNER JOIN은 양쪽 테이블에 모두 연결되는 데이터가 존재하는 경우에만 결과에 포함한다.
3. LEFT OUTER JOIN
왼쪽 테이블의 데이터를 모두 조회하고 오른쪽 테이블에서는 JOIN 조건을 만족하는 데이터를 조회한다.
오른쪽 테이블에 조건을 만족하는 데이터가 없다면 NULL 로 반환하면 된다.
SELECT u.id, u.name, o.product
FROM users u
LEFT JOIN orders o
    ON u.id = o.user_id;
결과는 다음과 같다.
| id | name | product |
| 1 | 은콩이 | 키보드 |
| 1 | 은콩이 | 마우스 |
| 2 | 모리 | 모니터 |
| 3 | 감자 | NULL |
이번에는 주문이 존재하지 않는 티모도 결과에 포함된다.
LEFT JOIN 에서는
FROM users u
LEFT JOIN orders o
에서 왼쪽에 위치한 users 테이블의 데이터는 반드시 결과에 포함되기 때문이다.
오른쪽 orders 테이블에서 연결된 데이터가 없다면 히 부분만 NULL이 된다.
4. LEFT JOIN으로 연결되지 않은 데이터 찾기
LEFT JOIN은 한쪽 테이블에만 존재하는 데이터를 찾을 때도 활용할 수 있다.
예를 들어 한번도 주문하지 않은 사용자를 찾는다고 하자.
SELECT u.id, u.name
FROM users u
LEFT JOIN orders o
    ON u.id = o.user_id WHERE o.id IS NULL;
orders에 연결되는 데이터가 없는 경우 오른쪽 데이터가 NULL이 되므로 이를 이용할 수 있다.
2. 이진 탐색(Binary Search)
1. 이진 탐색이란?
정렬된 데이터에서 탐색 범위를 절반씩 줄여가며 원하는 값을 찾는 알고리즘.
일반적인 순차 탐색은 처음부터 데이터를 하나씩 확인한다.
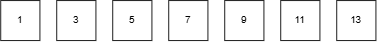
13을 찾는 경우
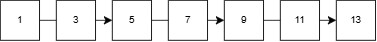
데이터가 많아질수록 확인해야 하는 데이터도 증가한다.
반면 이진 탐색은 중간값을 확인하고 찾으려는 값이 중간값보다 큰지 작은지를 판단하여 필요 없는 절반의 탐색 범위를 제거한다.
2. 이진 탐색의 동작 원리
위와 같이 오름차순으로 정렬된 배열에서 11을 찾는다고 하자
먼저 탐색 범위의 중간값을 확인한다.
[중앙값 사진]
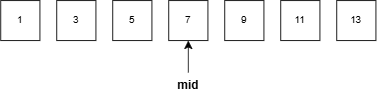
중간값은 7 이다.
따라서 7보다 작은 왼쪽 영역은 탐색할 필요가 없다.
다시 남은 범위의 중간값을 확인한다.
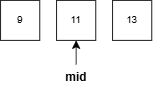
중간값이 11 이므로 원하는 값을 찾았다.
즉 이진 탐색은 다음 과정을 반복한다.
1. 탐색 범위의 중간값(mid)을 찾는다.

2. target == mid
    → 탐색 성공

3. target < mid
    → 왼쪽 절반 탐색

4. target > mid
    → 오른쪽 절반 탐색

5. 값을 찾거나 탐색 범위가 없어질 때까지 반복
3. 이진 탐색 구현
자바에서는 다음과 같이 구현할 수 있다.
public int binarySearch(int[] arr, int target) {
    int left = 0;
    int right = arr.length - 1;

    while (left <= right) {
        int mid = left + (right - left) / 2;

        if (arr[mid] == target) {
            return mid;
        }

        if (arr[mid] < target) {
            left = mid + 1;
        } else {
            right = mid - 1;
        }
    }

    return -1;
}
핵심은 left , right, mid 세 값을 이용해 탐색 범위를 줄이는 것이다.
target > arr[mid]

left = mid + 1
반대로
target < arr[mid]

right = mid - 1
로 범위를 변경한다.
4. 이진 탐색의 시간 복잡도
이진 탐색의 시간 복잡도는
O(log N)이다.
그 이유는 한 번 탐색할 때마다 탐색 대상이 절반으로 감소하기 때문이다.
예를 들어 데이터가 1,024개 있다고 하자.

약 10번의 탐색만으로 하나의 데이터까지 범위를 줄일 수 있다.
5. 이진 탐색의 조건
이진 탐색을 적용하기 위한 가장 중요한 조건은 데이터가 탐색 기준에 따라 정렬되어 있어야 한다는 것이다.
다음과 같이 정렬되어 있지 않다면 이진 탐색을 바로 적용할 수 없다.

이진 탐색은 중간값과 target을 비교한 결과를 통해 한쪽 영역 전체를 탐색 대상에서 제외한다.
정렬되어 있지 않다면
target > mid
라는 사실만으로 target이 오른쪽에 있다고 판단할 수 없기 때문이다.
따라서 중간값과의 비교를 통해 어느 절반을 버릴지 판단할 수 있도록 데이터에 순서가 존재해야 한다.
6. 정렬 비용까지 고려해야 한다.
정렬되지 않은 데이터를 이진 탐색하기 위해 매번 정렬해야 한다면 정렬 비용도 고려해야 한다.
일반적인 효율적인 정렬 알고리즘의 시간 복잡도는
O(N log N)
이고, 이후 이진 탐색은
O(log N)
이다.
따라서 단 한 번 값을 찾기 위해 정렬 O(N log N) + 이진 탐색 O(log N)을 수행하는 것이 항상 유리한 것은 아니다.
반대로 한 번 정렬한 데이터를 대상으로 검색을 반복적으로 수행한다면 이후 검색을 O(log N)에 처리할 수 있으므로 이진 탐색의 장점이 커진다.
'CS & Algorithm > CS' 카테고리의 다른 글
| [CS] CPU 스케줄링과 TCP/UDP 차이 (0) | 2026.09.03 |
|---|---|
| [CS] GC와 Spring MVC 요청 처리 과정 (0) | 2026.09.03 |
| [Plus] Let’s Encrypt 인증서를 적용하면 HTTPS는 어떻게 동작할까? (0) | 2026.08.30 |
| [CS] 가상 메모리와 HTTP vs. HTTPS (0) | 2026.08.30 |
| [CS] String 객체와 싱글톤 빈 (0) | 2026.08.29 |