
1. LLM
1. LLM이란?
LLM(Large Language Model)은 대규모 데이터를 학습하여 자연어를 이해하고 생성하는 딥러닝 기반 언어 모델이다.
LLM은 입력된 문장을 보고 다음에 올 토큰(Token)을 확률적으로 예측하는 과정을 반복하여 응답을 생성한다.
2. LLM 동작 원리
지금까지 주어진 내용 다음에 올 토큰을 확률적으로 예측하고, 그중 그럴듯한 토큰을 선택하는 과정을 반복한다.
입력: "대한민국의 수도는"

모델의 계산:
"서울" → 92%
"부산" → 3%
"인천" → 1%

→ "서울" 선택
→ 다음 토큰 예측
→ "입니다" 선택
→ ...
LLM은 데이터베이스에서 사실을 조회해서 답하는 것이 아니라 주어진 내용을 바탕으로 그럴듯한 다음 토큰을 생성한다.
따라서 실제로는 틀린 내용을 사실처럼 생성하는 할루시네이션(Hallucination)이 발생할 수 있다.
3. 토큰(Token)과 토큰화(Tokenization)
모델은 문장을 그대로 이해하는 것이 아니라 토큰(Token)이라는 단위로 쪼개서 처리한다.
문장을 토큰 단위로 나누는 과정을 토큰화(Tokenization)라고 한다.
토큰은 LLM에서 중요한 기준으로 사용된다.
- API 사용 요금
- 모델이 한 번에 처리할 수 있는 데이터의 양
- 입력 및 출력 크기
즉, 토큰 수가 많아질수록 처리해야 하는 데이터와 API 비용도 증가할 수 있다.
2. Spring AI
1. Spring AI란?
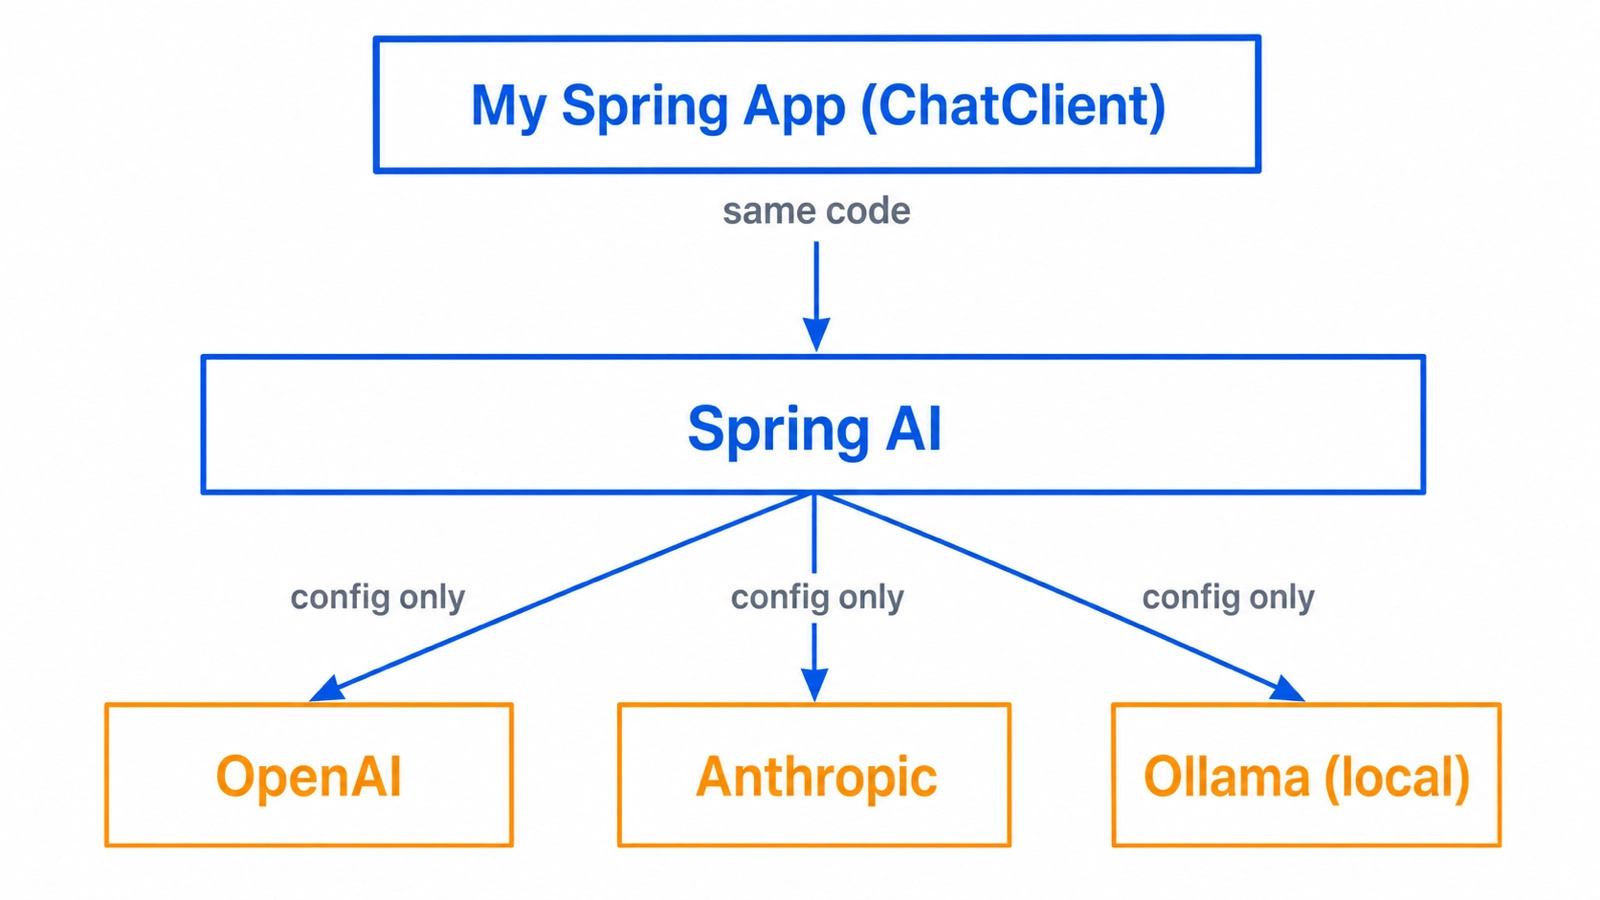
OpenAI, Ollama 등 서로 다른 AI 모델을 동일한 방식으로 사용할 수 있도록 추상화한 Spring 프로젝트
각 AI 모델의 API를 직접 호출하면 모델마다 요청/응답 형식이나 설정 방법이 다르기 때문에 모델을 변경할 때 코드 수정이 필요할 수 있다.
Spring AI는 이러한 차이를 추상화하여 동일한 인터페이스로 사용할 수 있도록 한다.
Spring Application
        ↓
    Spring AI
        ↓
OpenAI / Ollama / ...
Spring에서 DB 접근 기술을 추상화하는 것처럼 AI 모델의 차이를 추상화한 PSA(Portable Service Abstraction)의 사례라고 볼 수 있다.
Spring AI는 AI 모델이 아니라 AI 모델을 사용하기 위한 추상화 계층이다.
Spring AI가 해주는 것
- 모델별 API 차이 흡수 — 요청·응답 형식이 다른 여러 모델을 하나의 인터페이스로
- Spring Boot 자동 설정 — 의존성을 추가하고
application.yml만 채우면 스프링부트가 필요한 빈을 대신 만들어 등록 - 응답을 자바 객체로 변환 — JSON을 손으로 파싱하지 않고 원하는 클래스로 바로 받음
- 프롬프트 템플릿 — 프롬프트에 변수를 끼워 넣는 틀을 제공
- 대화 메모리 — 이전 대화를 자동으로 다시 넣어주는 장치를 제공
- Vector Store 추상화 — 벡터 데이터베이스도 같은 방식으로 감싸줌
2. ChatClient
Spring AI에서 LLM과 대화하기 위해 사용하는 고수준 인터페이스
public String ask(String question) {
    return chatClient.prompt()
            .user(question)
            .call()
            .content();
}prompt(): 프롬프트 생성user(): 사용자 메시지 설정call(): LLM 호출content(): 응답 내용을 문자열로 반환
직접 REST API를 호출할 때 필요한 요청/응답 DTO 생성이나 JSON 파싱 등의 작업을 줄일 수 있다.
3. 메시지의 종류
LLM에 전달하는 메시지는 역할에 따라 구분된다.
| 메시지 | 역할 |
| System | 모델의 역할과 동작 규칙 지정 |
| User | 사용자의 질문 |
| Assistant | 모델이 이전에 생성한 답변 |
chatClient.prompt()
        .system("너는 개발 개념을 쉽게 설명하는 도우미야.")
        .user("Spring의 DI가 뭐야?")
        .call()
        .content();
System Message를 통해 모델의 역할이나 답변 방식 등을 지정할 수 있다.
4. Structured Output
LLM의 응답은 기본적으로 문자열이다.
Spring AI에서는 .entity()를 사용하여 LLM의 응답을 Java 객체로 변환하여 받을 수 있다.
public record MovieRecommendation(
        String title,
        int releaseYear,
        String reason
) {}
MovieRecommendation result = chatClient.prompt()
.user("SF 영화를 한 편 추천해줘.")
.call()
.entity(MovieRecommendation.class);
LLM의 응답을 DB에 저장하거나 다른 비즈니스 로직에서 사용할 때 유용하다.
3. Context
1. LLM은 이전 대화를 기억할까?
LLM API는 기본적으로 Stateless하다.
즉, 각각의 요청은 독립적으로 처리되며 모델이 이전 요청을 스스로 기억하지 않는다.
1번째 요청
"내 이름은 은콩이야."

2번째 요청
"내 이름이 뭐야?"
2번째 요청에 이전 대화 내용을 함께 전달하지 않으면 모델은 이름을 알 수 없다.
대화가 이어지는 것처럼 보이는 이유는 이전 대화를 다음 요청의 Context에 다시 포함하여 전달하기 때문이다.
2. Context란?
한 번의 요청에서 모델에게 전달되는 전체 정보
Context에는 다음과 같은 내용이 포함될 수 있다.
System Message
+
이전 대화
+
참고 자료
+
현재 질문
LLM은 기본적으로 현재 Context에 들어온 정보를 기반으로 응답을 생성한다.
3. Context Window
모델이 한 번에 처리할 수 있는 Context의 최대 크기
Context Window의 크기는 Token 단위로 결정된다.
대화가 길어질수록 이전 대화를 계속 함께 전달해야 하기 때문에 입력 토큰도 증가한다.
1번째 질문
→ 질문 1

2번째 질문
→ 질문 1 + 답변 1 + 질문 2

3번째 질문
→ 질문 1 + 답변 1 + 질문 2 + 답변 2 + 질문 3
따라서 대화가 길어질수록 토큰 사용량과 비용이 증가할 수 있다.
모든 정보를 Context에 넣는 것보다 현재 질문에 필요한 정보를 선별해서 넣는 것이 중요하다.
4. Prompt Engineering과 Context Engineering
1. Prompt Engineering
LLM에게 어떻게 질문할 것인지를 설계하는 것
❌ "이 로그 분석해줘."

⭕ "아래 Spring Boot 로그를 분석하고
1. 예외 발생 원인
2. 의심되는 코드
3. 해결 방법
순서로 알려줘."
역할, 조건, 출력 형식 등을 구체적으로 지정하면 원하는 형태의 응답을 얻기 쉬워진다.
2. Context Engineering
LLM에게 어떤 정보를 제공할 것인지를 설계하는 것
예를 들어 LLM은 회사 내부의 규정을 기본적으로 알 수 없다.
[참고 문서]
연차는 15일이며...

[질문]
우리 회사 연차는 며칠이야?
따라서 필요한 정보를 찾아 Context에 함께 넣어주어야 한다.
| 구분 | 핵심 |
| Prompt Engineering | 어떻게 물어볼 것인가 |
| Context Engineering | 무엇을 넣어줄 것인가 |
서비스에서는 모든 정보를 넣는 것이 아니라 현재 질문과 관련 있는 정보를 찾아 Context에 넣는 것이 중요하다.
이때 관련 정보를 검색하여 Context에 제공하는 대표적인 방법이 RAG(Retrieval-Augmented Generation)이다.
5. LLM API 사용 시 고려사항
1. API Key 관리
API Key를 프론트엔드에 저장하면 브라우저를 통해 노출될 수 있기 때문에 백엔드에서 관리해야 한다.
Client
  ↓
Backend
  ↓
LLM API
API Key는 코드에 직접 작성하지 않고 환경변수 등을 이용한다.
spring:
  ai:
    openai:
      api-key: ${OPENAI_API_KEY}
API Key가 Git 등에 노출되었다면 기존 Key를 폐기(Revoke)하고 새로 발급해야 한다.
2. 비용
LLM API는 사용한 토큰을 기준으로 비용이 발생한다.
따라서 실제 서비스에서는 다음과 같은 부분을 고려해야 한다.
- 불필요한 Context 제거
- 응답 길이 제한
- 작업에 맞는 모델 선택
- 반복되는 요청 캐싱
- 사용자별 호출 횟수 제한
특히 반복문 내부에서 LLM API를 호출하면 반복 횟수만큼 API 호출과 비용이 발생할 수 있으므로 주의해야 한다.
'개발 공부 > Java' 카테고리의 다른 글
| [SPRING] JPA와 MyBatis (0) | 2026.10.09 |
|---|---|
| [TIL] 장애 대응 (0) | 2026.08.21 |
| [TIL] 모니터링 시스템 및 시큐어 코딩 (0) | 2026.08.21 |
| [TIL] 대규모 시스템 설계 기초 (0) | 2026.07.28 |
| [TIL] Redis 자료구조와 캐싱(Cache) (0) | 2026.07.28 |